
304永利集团官网入口-DeepSeek的500亿会花在哪?
首页财产阐发评论ai正文 DeepSeek的500亿会花于哪? 6月16日媒体报导DeepSeek完成超500亿元首轮外部融资,投后估值超500亿美元。其将发力AI coding,资金或者重要投算力,还有将优化模子与履行层,以构建AI出产力基础举措措施。 2026-06-23 15:25 ·微信公家号:最话FunTalk 林书 编纂 刘宇翔 林书 编纂 刘宇翔 AI投资人解读· DeepSeek完成超500亿元首轮外部融资,投后估值超500亿美元,为中国AI行业迄今最年夜单轮融资。其战略用意是办事开发者及企业,将模子能力转化为出产力东西。 · 行业竞争激烈,算力紧缺,政策羁系等因素或者影响其成长。 总结:DeepSeek资金实力雄厚,成长标的目的明确,但面对诸多挑战。其于AI coding范畴的结构,有望鞭策AI从消费叙事转向出产叙事,具备较年夜成长潜力,值患上存眷其技能进展与市场体现。内容由AI天生,仅供参考
DeepSeek的Harness团队于北京海淀区融科资讯中央,十年前我曾经于那里事情。这不是想往脸上贴金,而是很遗憾,错过了见证汗青的一刻。
6月16日,据媒体报导,DeepSeek完成为了建立以来的首轮外部融资,召募资金跨越500亿元人平易近币,投后估值冲破500亿美元。开创人梁文锋小我私家出资200亿元,为最 年夜单一出资方;腾讯出资100亿元,宁德时代系统出资约50亿元,京东、网易和IDG本钱各出资30亿元。
这是中国AI行业迄今范围最 年夜的单轮融资。
那末,拿到巨额融资的DeepSeek,会把钱投向哪一个标的目的?
6月15日,从论坛流出的一则信息可能让咱们可以坐井观天。据一名介入测试的用户称,DeepSeek V4.1于网页端启动灰度测试,他说V4.1 Flash的代码能力实现了“天差地别”的超过式前进,常识截止日期也从2025年5月跃升至2026年1月,部门用户甚至测出了2026年5月的截止日期。
极可能AI coding就是DeepSeek行将发力的标的目的。
实在,5月,DeepSeek的一则雇用缘由也吐露了这点,那则Agent Harness研发工程师的雇用缘由里,写了一行简便的公式:Model + Harness = Agent。岗亭描写进一步注释道,“把前沿模子能力,转化为领 先的Agent产物。Harness+除了模子自己之外的所有事情”。
AI coding+Agent,看来,DeepSeek接下来的方针是想对于标Anthropic旗下的Claude Code。DeepSeek做coding,由于这个范畴能用最严酷的尺度来测试及铸造模子的推理能力,不仅是今朝唯 一被验证的、能形成贸易闭环的场景,更是AI出产力的基础举措措施。
01
DeepSeek没兴致于C端及豆包、千问、元宝争取用户。从这轮融资的资金用途、产物结构、人材引进以和市场验证来看,DeepSeek的战略用意很清楚:办事好开发者及企业,把模子能力转化为出产力东西,成为AI时代的“基础举措措施”提供商。
虽然DeepSeek没有公然资金分配比例,但从其战略用意及行业趋向,可以反推可能的分配比例:
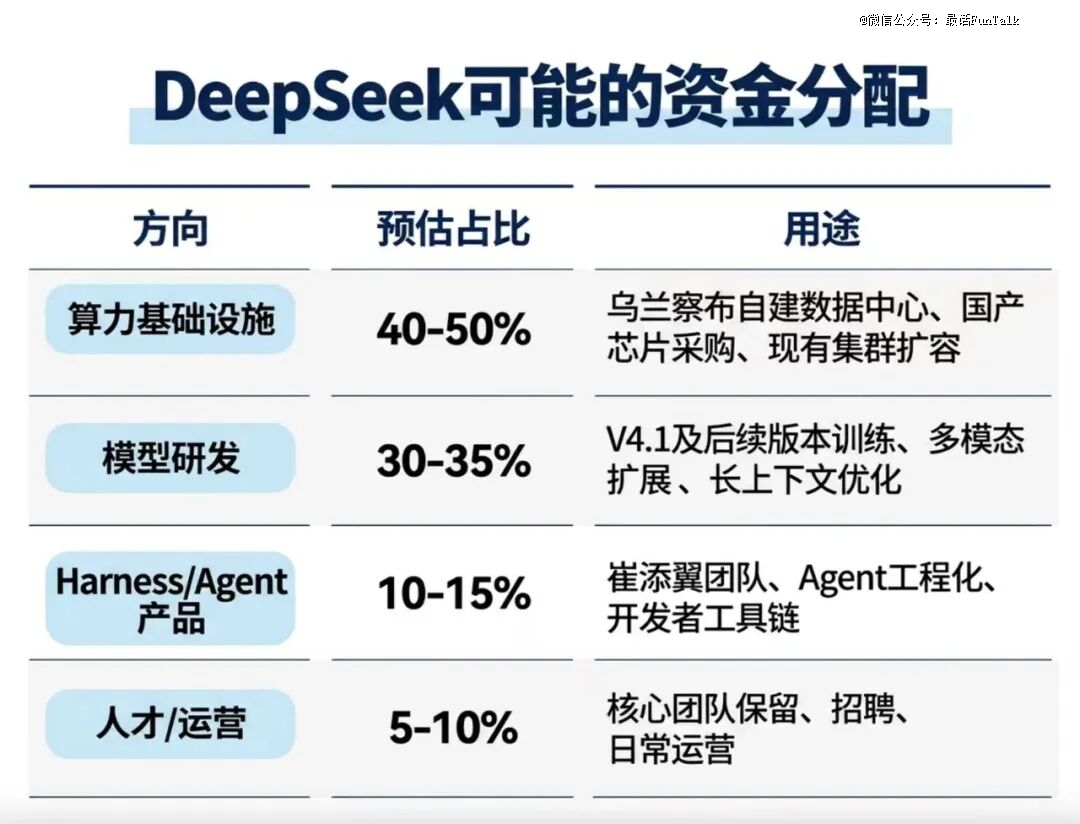
500亿的年夜头年夜几率会砸于算力上,究竟从久远来看,DeepSeek始终处于算力边际紧缺的状况,不管是要练习出新一代模子,还有是要满意用户挪用量的增加。
前段时间,DeepSeek于内蒙古乌兰察布雇用智算中央职员,岗亭有高级运维工程师、高级交付司理,月薪开到15K到30K,还有配14薪,还有设立“IDC设计计划工程师”岗亭,计划MW到GW级的超年夜范围智算中央。这申明,DeepSeek正从租用机房转向年夜范围自建数据中央。
咱们相识到,除了了自有算力,早于2025年,浙江许多空置的算力中央都给DeepSeek挪用。即便有外部算力供应,算力依旧因此和会是DeepSeek持久要面临的难题,近期其“专家模式”取缔了联网搜刮功效,而且限定天生次数,就从侧面申明了这点。
算力是Coding基础举措措施的物理底座。假如V4.1的机能晋升,挪用量增长,以现有算力更难蒙受。没有算力,V4.1再强也只能限流,没有算力,Harness再好用也跑不起来。
可以比拟较的是于coding范畴最强的Anthropic,它采纳“多云绑定+专属集群”的激进计谋,已经构建笼罩GPU、TPU和自研芯片的多元供给收集,2025年末可用算力约1.4吉瓦,估计2026年末将快速晋升至7-8吉瓦区间。但仅2026年第 一季度其收入与利用量按年化计较就增加80倍,远超原有基础举措措施承载能力,致使办事曾经呈现限流与机能颠簸。
Anthropic CEO达里奥·阿莫迪暗示算力需求呈指数级发作,公司正全力设置装备摆设以匹配这一“疯狂”增速,方针是于将来几年内实现吉瓦级容量的连续开释。
AI Infra(基础举措措施)是一项重资产、长周期的投入,DeepSeek还有于高速成长,理论上,它彻底可以租用更多算力,为何要本身吃力为处置惩罚海量、繁杂的B端AI事情负载提供不变、低成本的算力底座呢?
由于DeepSeek的技能线路,决议了它必需拥有Infra的绝 对于节制权,必需于Infra层就做优化。
为了只管即便压榨算力,DeepSeek做FP8练习,需要写通讯库、调精度赔偿计谋、改NCCL,英伟达原生的通讯库不撑持这类级另外自界说;DeepSeek本身从头设计KV Cache的存储及调理,由于尺度推理引擎(vLLM、TensorRT-LLM)的架构假定及它要的纷歧样;DeepSeek要设计MoE负载平衡,本身写路由算法,让专家漫衍于特定的节点拓扑上,削减跨机通讯,而不克不及简朴用云厂商的Kubernetes主动扩缩容。等等。
这些都需要于“算法-芯片-收集-框架”的每一一层做定制优化,云厂商的尺度化办事满意不了。Anthropic能继承堆参数、超年夜范围线路,是由于它有亚马逊云及Google Cloud的可“无穷扩容”算力撑持,用不着于Infra层面做极 致优化。
DeepSeek没有这个前提,以是只能本身做地基,但这些努力也恰是DeepSeek的竞争力来历。
这些优化不是伶仃的,而是乘法瓜葛。从公然的技能架构差异及行业成本模子,架构优化×精度优化×Infra优化×推理优化叠加,使患上DeepSeek的单元算力成本比Anthropic的低患上多。
02
算力是地基。地基之上,DeepSeek另两个年夜投入标的目的是模子层及履行层。
6月15日那则V4.1灰度测试的帖子,吐露的是DeepSeek于coding范畴的进展。据介入测试的用户称,V4.1 Flash的代码能力实现了“天差地别”的超过式前进。但咱们没能介入灰度测试,今朝其实不相识详细现实环境。
DeepSeek V4曾经以1.6T总参数、1M上下文窗口,于架构效率及成本布局上实现了周全冲破。但V4的Coding能力与业界顶 尖程度仍有差距,这也是社区会商至多的短板。V4.1的焦点使命,恰是最先补齐这块短板。
从序列号来看,V4.1是V4的增量版本,这象征着V4.1的焦点投入于后练习阶段(Post-Training),而非预练习(Pre-training),后练习成本凡是只有预练习的1/10到1/5。
DeepSeek朝出产力演进的标的目的已经经很明确的,而这恰是海内年夜模子企业与国际最高程度对于比最 年夜也是最紧急的短板。
假如把AI模子比作年夜脑,Agent/Harness这个履行层就是它的四肢举动及神经体系。没有履行层,年夜脑只能思索;有了履行层,年夜脑才能步履。已往一年,行业已经经证实了一个事实:模子能写代码,不等在能连续完成一个工程使命。真正转变开发者事情方式的,是Claude Code、Codex,一个可以或许进入终端、理解项目、读写文件、运行号令、修复过错、治理Git、挪用东西的工程智能体。
Coding是Harness的最 佳载体,由于代码自己就是可履行的用意,一行代码既是对于问题的描写,也是对于解决方案的切确指令。
Anthropic是最早把“模子写代码”进级为“模子做工程”的公司。2024年推出的Claude Code(以和此前的Claude Dev、Artifacts等功效),不是简朴的代码补全东西,而是一个完备的终端工程情况。Claude Code的火爆证实了一件事:AI Coding的竞争,正于从模子能力竞争,转向开发者事情流进口竞争。
模子是年夜脑,但年夜脑不克不及本身打字,你需要一套体系,把模子的用意转化为步履。那就是Harness。
Anthropic的AI coding端到端工程闭环的体验,是模子能力+Harness工程的两重堆集。Anthropic比竞争敌手早6-12个月跑通了这个闭环,形成为了开发者习气壁垒。当DeepSeek还有于做模子层时,Anthropic已经经于做事情流层了。
这类领 先不只是无穷算力加持下超年夜范围模子的能力输出,也是工程打磨的成果,这需要年夜量产物工程师、开发者体验设计师、DevOps专家的重复迭代。
以是,DeepSeek于推进V4.1以致V5的研发的同时,也于补足Agent/Harness能力。5月那则雇用缘由里的公式,Model + Harness = Agent,说的就是这个。
据媒体报导,DeepSeek Harness团队的卖力人是崔添翼,一名于Jane Street干了9年、厥后联创量化基金TSY Capital的生意业务体系专家。2026年2月,他脱离TSY Capital插手DeepSeek。DeepSeek找他来,恰是为了搭建Harness。
DeepSeek找了一个做量化生意业务体系的人来搭建Harness。这个选择暗地里的逻辑,比“偕行相惜”要深患上多。
一个逻辑合理的注释是,量化生意业务及AI Agent的底层逻辑是同样的:光有智慧的计谋不赚钱,真正把计谋酿成钱的,是履行体系。光有强模子也不敷,真正把模子酿成出产力的,是上下文治理、东西挪用、终端履行、测试反馈、权限节制、掉败回滚。这些除了模子自己之外的所有事情,都属在Harness的领域,也就是“履行”。
V4.1解决的是“能不克不及写对于代码”,Harness解决的是“写完后能不克不及跑通、报错后能不克不及自修、项目年夜了能不克不及协作”。前者是模子能力,后者是工程能力。只有二者联合,DeepSeek才有时机成立与Claude Code同级另外端到端工程智能。
这类挑战巨头的测验考试,对于工程师有很年夜的吸引力。今朝,崔添翼于社交媒体上发布的雇用帖子,已经经引来浩繁业界人士的送达。
03
Coding之以是成为必争之地,是由于它是今朝唯 一可验证、可量化、可闭环的AI出产力。
判定一个AI能力达不到达出产力程度,有一个简朴的尺度:它的输出能不克不及于不依靠人类主不雅判定的环境下,被验证对于错?
多模态模子天生一张图,好欠好看?需要人看。通用对于话模子回覆一个问题,对于不合错误?需要人判定。这些能力的验证成本极高,且尺度不同一,企业很难量化ROI。
但Coding的输出是一段步伐,计较机可以直接履行并给出pass/fail。写对于了就运行,写错了就报错。这类主动可验证性使患上Coding成为今朝唯 逐一种ROI可以被切确计较的AI能力,企业能算出这个模子替换了几多工程师工时、产出了几多可运行代码、削减了几多bug。
2026年的benchmark竞争格式印证了这一点。SWE-bench Verified(让模子解决真实GitHub issue的测试)已经经成为“single most-cited coding benchmark”及“most load-bearing single benchmark for real-world developer workflows”。按照第三方benchmark聚合平台llm-stats.com的数据,当前前沿模子于这个测试上的竞争进入了白热化:Claude Opus 4.5到达80.9%,Opus 4.6为80.8%,Gemini 3.1 Pro为80.6%,GPT-5.2为80.0%,差距仅于0.1到0.9个百分点之间。
但于SWE-bench Verified如许的真实使命上,0.9%的差距象征着:一个模子能自力解决某个繁杂issue并上线运行,而另外一个模子会于末了一步卡住。这不是差未几,而是能跑通及跑欠亨的区分。
而6月12日Anthropic被禁事务,进一步确认了Coding的基础举措措施职位地方。Anthropic最强盛的模子Claude Fable 5及Mythos 5被美国当局纳入出口管束,当天全世界停服。这是美国初次将贸易AI模子与进步前辈半导体划一看待,纳入出口管束清单。Fable 5的订价是input 美金10/M、output 美金50/M,这不是软件东西的订价,而是基础举措措施的订价。
是的,AI coding已经经是AI时代的出产力基础举措措施,有无是两个时代的分野:AI出产力时代及前AI出产力时代。这反向验证了DeepSeek朝AI coding演进的意义:Coding基础举措措施不克不及被垄断,必需平权化。
DeepSeek-V4-Flash缓存掷中输入价格仅为0.2元/百万tokens,约为Fable 5的1/138。但现实操作中,因为能力的短缺,总的token成本其实不必然比Fable 5低,更主要的是为出产力付费有马太效应:最 好用的会收成绝年夜大都用户,形成正反馈飞轮,而能力稍显短缺的,可能就成Other。
但若咱们把AI coding看做是出产力基础举措措施,那末当Coding基础举措措施的边际成本不停降低,全世界开发者也才能真正用上顶 尖的Coding能力,开释巨年夜出产力。以是,以此为维度,DeepSeek的低价线路,素质上是把AI出产力从豪侈品酿成日用品。
据介入融资的投资人转述,梁文锋对于所有投资人的最 大体求是“不要挖DeepSeek的人”。不是由于焦点团队流掉率高,事实上焦点团队很不变,去职者也不是做Coding的,而是当一小我私家坚信本身于做一件很主要的工作时,是不但愿他人来挖角打搅的。
今朝,Anthropic的Coding领 先是算法+算力+工程化+时间差的盈余,马斯克认为最早到来岁Q1,中国AI团队就能造出Mythos 5量级的模子,但智谱的唐杰认为会更快。谁对于谁错,由时间来证实。
但让AI成为像水电同样的基础举措措施,像TCP/IP、像Linux、像电网,成为准大众品(Quasi-Public Good),会是AI出产力开释的要害。DeepSeek拿着500亿,赌的就是Coding真正成为基础举措措施,人人可用。
DeepSeek假如能于coding上成立“低成本+高机能+完备东西链”的上风,它现实上是于把AI从消费叙事切换到出产叙事。这不仅对于DeepSeek本身主要,对于中国整个AI财产都很要害。
十年前,我于融科资讯中央事情时,那群楼里还有没有一家AI公司,此刻,DeepSeek的Harness团队正于那内里试产物司理。从乌兰察布的智算中央,到V4.1的蓄势待发,DeepSeek正于推进它的规划。
遗憾的是,我没能力介入此中,只能记下这些不雅察。让时间去验证它的对于错。
【本文由投资界互助伙伴微信公家号:最话FunTalk授权发布,本平台仅提供信息存储办事。】【免责声明】:本文不组成任何投资建议。市场有危害,投资需审慎。若有任何疑难,请接洽(editor@zero2ipo.com.cn)投资界处置惩罚。
-304永利集团官网入口


